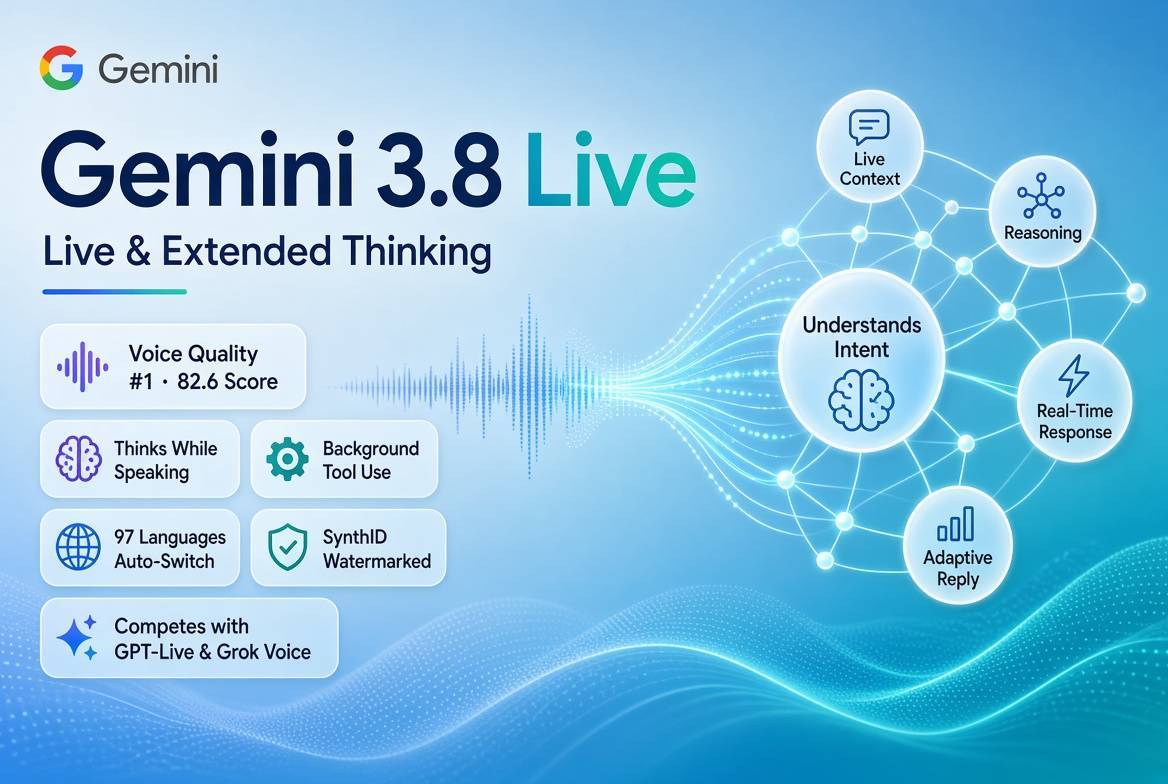
گزارش ICTNews – گوگل در تاریخ ۱۵ سپتامبر ۲۰۲۶ (۲۴ شهریور ۱۴۰۵) از دو مدل جدید گفتوگوی زنده خود رونمایی کرد. مدل Gemini 3.8 Live برای مقیاسپذیری و بهینهبودن هزینه طراحی شده و مدل Gemini 3.8 Live Extended Thinking برای وظایف بسیار پیچیده با استدلال چندمرحلهای ساخته شده است. این دو مدل صوتی در رقابت با GPT-Live-1 Astra و Grok Voice وارد بازار شدهاند و از طریق Gemini API و Google AI Studio در اختیار توسعهدهندگان قرار گرفتهاند.
Gemini 3.8 Live؛ بهینه برای مقیاسپذیری
Gemini 3.8 Live ترکیبی از هوش مکالمهای، گفتوگوی روان و درک بصری را ارائه میدهد. این مدل برای کاربردهایی طراحی شده که به حجم بالای پردازش صوتی نیاز دارند و هزینه بهینه برای توسعهدهندگان اهمیت بالایی دارد.
در شاخص کیفیت گفتوگوی صوتی Artificial Analysis، این مدل امتیاز ۷۶.۰ را کسب کرده و در Speech Agent Arena رتبه دوم را از نظر ترجیح کاربران به دست آورده است.
Gemini 3.8 Live Extended Thinking؛ استدلال چندمرحلهای
مدل Extended Thinking برای وظایف بسیار پیچیده طراحی شده و از استدلال چندمرحلهای پشتیبانی میکند. مهمترین نوآوری این مدل، قابلیت «فکر کردن همزمان با صحبت کردن» است. این مدل با استفاده از نشانههای کلامی طبیعی مانند «بگذارید بررسی کنم…» درخواست کاربر را تأیید میکند و با روایت زنده پیشرفت کار، او را در جریان مراحل چندگانه قرار میدهد.
در شاخص کیفیت گفتوگوی صوتی Artificial Analysis، این مدل با امتیاز ۸۲.۶ رتبه نخست را کسب کرده و از GPT-Live-1 Astra با امتیاز ۸۱.۵ و Grok Voice Think Fast 2.0 با امتیاز ۸۱.۳ پیشی گرفته است. در بنچمارک Big Bench Audio نیز امتیاز ۹۷.۷ درصد در استدلال صوتی ثبت کرده است.
اجرای ابزارها در پسزمینه
هر دو مدل میتوانند ابزارها و APIها را در پسزمینه اجرا کنند بدون اینکه مکالمه قطع شود. کاربر میتواند درخواستی بدهد و مدل ضمن تأیید آن، در پسزمینه کار را انجام دهد و همزمان به گفتوگو ادامه دهد. این قابلیت برای کاربردهایی مانند رزرو بلیت، پیگیری سفارش یا جستجوی اطلاعات بسیار کاربردی است.
پشتیبانی از ۹۷ زبان
Gemini 3.8 Live میتواند میان ۹۷ زبان پشتیبانیشده در میانه گفتوگو بهطور خودکار جابهجا شود و یکپارچگی لهجه را حفظ کند. این ویژگی برای کاربران چندزبانه و کسبوکارهای بینالمللی مزیت قابلتوجهی محسوب میشود.
قیمتگذاری و دسترسی
قیمت هر دقیقه ورودی صوتی ۰.۰۰۵ دلار و هر دقیقه خروجی صوتی ۰.۰۱۸ دلار است. به این ترتیب، یک ساعت گفتوگوی دوطرفه حدود ۱.۳۸ دلار هزینه خواهد داشت.
دسترسی مصرفکنندگان:
· Gemini 3.8 Live در Search Live برای عموم کاربران در دسترس است· Gemini 3.8 Live Extended Thinking در Gemini Live و برای مشترکان Google AI Pro و Ultra در Docs، و برای تمام مشترکان AI در Gmail و Keep
نشانهگذاری SynthID
تمام صداهای تولیدشده توسط این مدلها با فناوری SynthID واترمارک میشوند تا محتوای تولیدشده با هوش مصنوعی قابل شناسایی باشد. این اقدام گوگل در راستای شفافیت و جلوگیری از سوءاستفاده از محتوای صوتی مصنوعی انجام شده است.
شرکای توسعهدهنده و سازمانی
پلتفرمهایی مانند Agora، LangChain، LiveKit، Pipecat و Vercel از Live API برای ساخت برنامههای صوتی استفاده میکنند. گوگل همچنین با شرکتهایی مانند Salesforce، Genspark و Lumeris همکاری میکند که از سرعت، روانی و قابلیت اجرای وظایف این مدلها در حین گفتوگو تمجید کردهاند.
تحلیل ICTNews
معرفی دو مدل گفتوگوی زنده گوگل، نشاندهنده عزم این شرکت برای تسخیر بازار دستیارهای صوتی هوش مصنوعی است. مدل Extended Thinking با کسب رتبه نخست در شاخص کیفیت گفتوگوی صوتی و پیشی گرفتن از GPT-Live-1 Astra و Grok Voice، جایگاه گوگل را در این حوزه تثبیت کرده است. قابلیت «فکر کردن همزمان با صحبت کردن» نیز یک نوآوری مهم محسوب میشود که تجربه کاربری طبیعیتری را فراهم میکند. با این حال، رقابت در این حوزه بسیار فشرده است و شرکتهایی مانند OpenAI و xAI نیز بهسرعت در حال توسعه مدلهای صوتی خود هستند. موفقیت گوگل در این بازار به توانایی آن در جذب توسعهدهندگان و ارائه تجربه کاربری روان و بدون وقفه بستگی دارد.