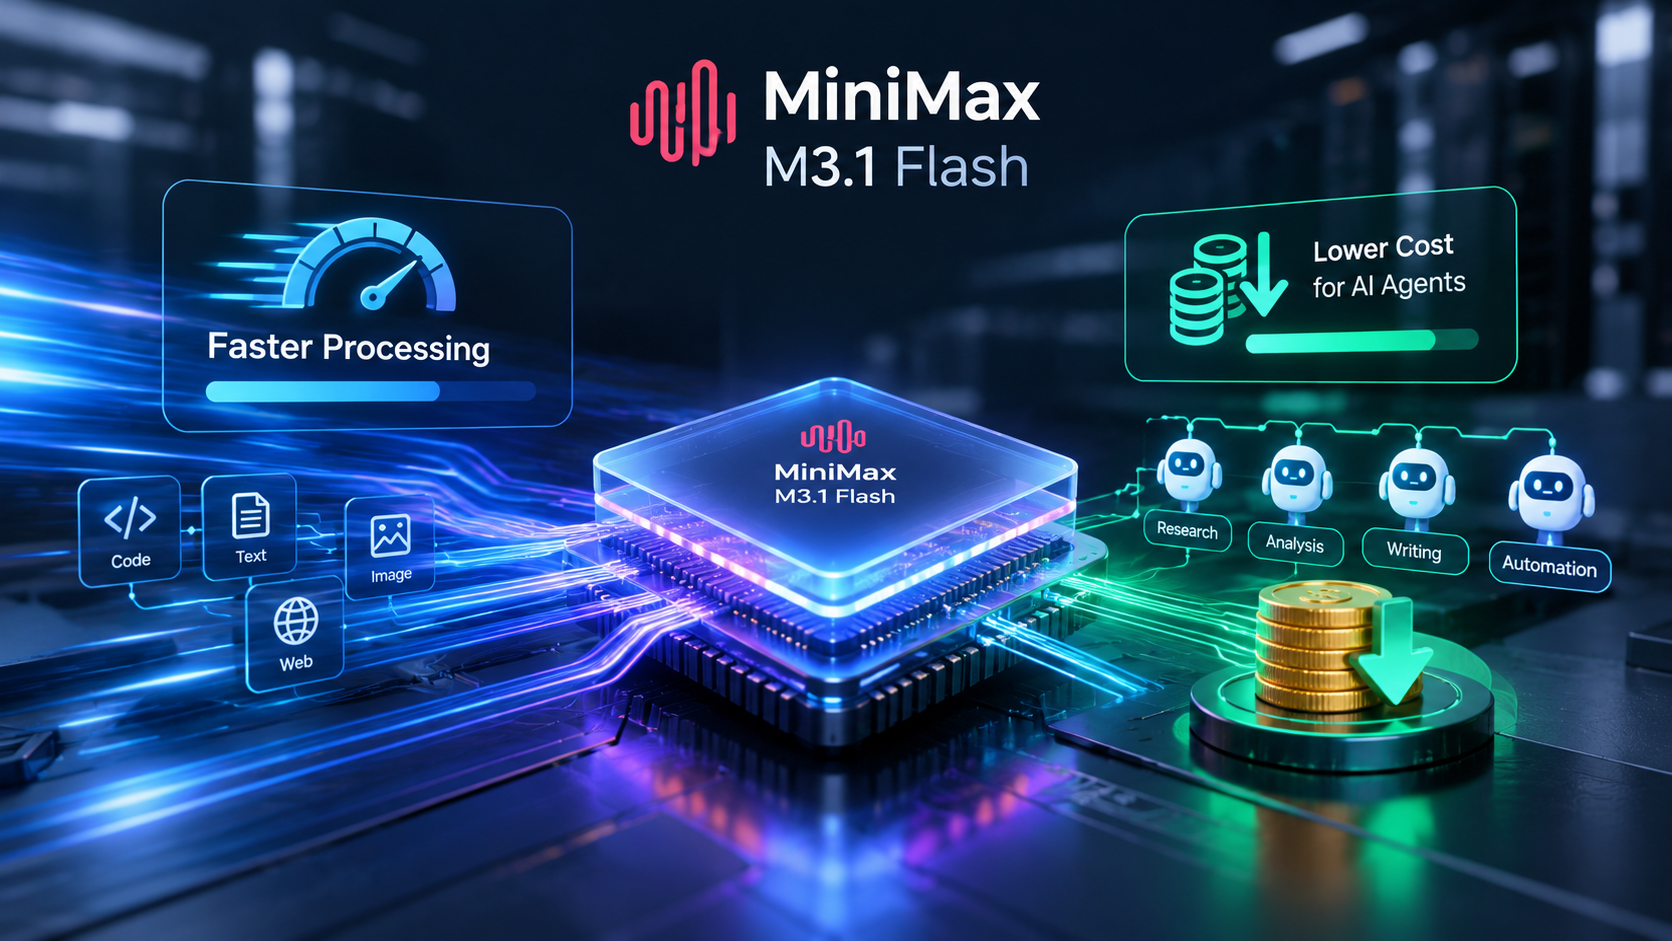
آی تی جو > دنیای فناوری > هوش مصنوعی > MiniMax M3.1 Flash معرفی شد؛ مدل چینی که روی سرعت و هزینه کمتر تمرکز دارد MiniMax M3.1 Flash معرفی شد؛ مدل چینی که روی سرعت و هزینه کمتر تمرکز دارد MiniMax M3.1 Flash مدل هوش مصنوعی جدید شرکت چینی MiniMax است که برای کدنویسی و اجرای وظایف عاملمحور طراحی شده است. شرکت سازنده از افزایش نزدیک به سهبرابری سرعت استنتاج و کاهش ۷۰ درصدی هزینه استفاده خبر میدهد؛ این ارقام به شرایط استفاده وابستهاند و باید با ارزیابی مستقل سنجیده شوند. ارسال شده توسط تیم تحریریه آیتیجو ۳ آبان ۱۴۰۵ هوش مصنوعی MiniMax M3.1 Flash شرکت چینی MiniMax در ۱۹ اکتبر ۲۰۲۶ از مدل هوش مصنوعی MiniMax M3.1 Flash رونمایی کرد؛ مدلی که با تمرکز بر اجرای سریعتر وظایف، برنامهنویسی و کار با عاملهای هوش مصنوعی (AI Agents) توسعه یافته است. این شرکت ادعا میکند نسخه جدید در مقایسه با مدل قبلی، سرعت استنتاج آنلاین را تقریباً سه برابر میکند و هزینه استفاده را تا ۷۰ درصد کاهش میدهد. البته این ارقام فعلاً باید بهعنوان ادعاهای سازنده در نظر گرفته شوند، نه نتیجهای که در همه شرایط مستقلانه تأیید شده باشد. رقابت مدلهای هوش مصنوعی دیگر فقط بر سر پاسخهای هوشمندانهتر نیست. سرعت پاسخگویی، هزینه پردازش و توانایی انجام کارهای چندمرحلهای نیز اهمیت زیادی پیدا کردهاند؛ بهویژه برای شرکتها و توسعهدهندگانی که عاملهای هوش مصنوعی را بهصورت مداوم اجرا میکنند. نکات مهم درباره MiniMax M3.1 Flash سرعت بیشتر: MiniMax از افزایش نزدیک به سهبرابری سرعت استنتاج آنلاین نسبت به نسل قبلی خبر داده است. هزینه کمتر: شرکت مدعی است هزینه استفاده در سناریوهای هدف تا ۷۰ درصد کاهش یافته است. تمرکز بر عاملهای هوش مصنوعی: مدل برای انجام وظایف چندمرحلهای، کار با ابزارها و گردشکارهای خودکار طراحی شده است. کاربرد در برنامهنویسی: کدنویسی و انجام وظایف نرمافزاری از حوزههای اصلی معرفی این مدل هستند. دسترسی توسعهدهندگان: مدل از طریق پلتفرم و API شرکت MiniMax قابل استفاده است. MiniMax M3.1 Flash چه قابلیتهایی دارد ۱. اجرای سریعتر وظایف هوش مصنوعی سرعت پاسخگویی برای چتباتی که تنها به یک پرسش جواب میدهد مهم است، اما در عاملهای هوش مصنوعی اهمیت بیشتری پیدا میکند. یک عامل ممکن است برای تکمیل یک کار، چندین بار مدل را فراخوانی کند، اطلاعات را بررسی کند، ابزارهای مختلف را به کار بگیرد و نتیجه را اصلاح کند. در چنین شرایطی، حتی کاهش زمان هر مرحله میتواند زمان اجرای کل فرایند را پایین بیاورد. MiniMax میگوید M3.1 Flash برای این نوع استفاده بهینه شده و سرعت استنتاج آنلاین آن نسبت به نسخه قبلی تقریباً سه برابر است. بااینحال، سرعت واقعی به عواملی مانند طول ورودی، پیچیدگی وظیفه، بار سرورها و نحوه پیادهسازی بستگی دارد. ۲. کاهش هزینه اجرای عاملهای هوش مصنوعی یکی از مهمترین بخشهای معرفی این مدل، تمرکز بر هزینه انجام یک وظیفه کامل است. هزینه یک عامل هوش مصنوعی صرفاً به قیمت هر توکن محدود نمیشود؛ تعداد فراخوانیها، حجم ورودی و خروجی و میزان تلاش مدل برای رسیدن به نتیجه نیز در هزینه نهایی تأثیر دارند. MiniMax ادعا میکند M3.1 Flash میتواند هزینه استفاده را تا ۷۰ درصد کاهش دهد. این عدد به معنای ارزانتر شدن ۷۰ درصدی تمام پروژههای هوش مصنوعی نیست؛ میزان صرفهجویی واقعی به نوع کار و الگوی مصرف بستگی دارد. ۳. برنامهنویسی و انجام کارهای چندمرحلهای کدنویسی یکی از کاربردهای هدف این مدل است. عاملهای برنامهنویسی معمولاً باید کد تولید کنند، خطاها را بررسی کنند، تغییرات را اعمال کنند و گاهی از ابزارهای توسعه یا محیط اجرای کد کمک بگیرند. مدلی که این مراحل را با هزینه و تأخیر کمتر انجام دهد، میتواند برای توسعهدهندگان و تیمهای نرمافزاری جذاب باشد. بااینحال، سرعت بیشتر بهتنهایی تضمین نمیکند که کد تولیدشده دقیقتر، امنتر یا آماده انتشار باشد؛ کیفیت خروجی و میزان نیاز به بازبینی انسانی همچنان اهمیت دارد. ۴. کار با رایانه و وظایف امنیت سایبری MiniMax همچنین از بهبود توانایی مدل در استفاده از رایانه (Computer Use) و وظایف مرتبط با امنیت سایبری صحبت کرده است. این دسته از کاربردها میتواند شامل تعامل با ابزارهای نرمافزاری، اجرای مراحل مشخص و کمک به تحلیل وظایف فنی باشد. بااینوجود، اعلام شرکت درباره بهبود قابلیتها بهتنهایی برای اثبات برتری مدل در محیطهای واقعی کافی نیست. برای ارزیابی دقیقتر باید نتایج آزمونهای مستقل، نرخ خطا و عملکرد آن در وظایف عملی نیز بررسی شوند. قیمت MiniMax M3.1 Flash چقدر است؟ طبق صفحه رسمی MiniMax، قیمت استفاده از API بهازای هر یک میلیون توکن به شکل زیر اعلام شده است. این نرخها برحسب دلار هستند و هزینه نهایی پروژه به میزان مصرف و نوع پردازش بستگی دارد. نوع پردازش قیمت اعلامشده توکن ورودی ۰٫۱۵ دلار توکن خروجی ۰٫۶۰ دلار توکن ورودی ذخیرهشده (Cached Input) ۰٫۰۱۵ دلار تفاوت هزینه ورودی و خروجی در بسیاری از مدلهای زبانی رایج است؛ زیرا تولید پاسخ معمولاً به پردازش بیشتری نسبت به دریافت ورودی نیاز دارد. همچنین، استفاده از ورودیهای ذخیرهشده میتواند در درخواستهای تکراری هزینه را کاهش دهد. نکته مهم این است که ادعای کاهش ۷۰ درصدی هزینه، به هزینه اجرای وظایف عاملمحور در مقایسه موردنظر MiniMax مربوط میشود و نباید آن را با تخفیف ثابت ۷۰ درصدی روی تمام تعرفهها اشتباه گرفت. عملکرد MiniMax M3.1 Flash در بنچمارکها برای بررسی مدلهای هوش مصنوعی باید به آزمونهای عملکردی نیز توجه کرد. بااینحال، نتایج بنچمارکها همیشه به معنی عملکرد یکسان در پروژههای واقعی نیستند و ممکن است با تغییر روش آزمون، نسخه مدل یا تنظیمات اجرا تفاوت داشته باشند. بر اساس گزارش The Decoder که به دادههای Artificial Analysis استناد میکند، امتیاز M3.1 Flash در شاخص Intelligence Index به ۴۲ رسیده است؛ درحالیکه امتیاز نسخه قبلی M3 برابر با ۲۹ گزارش شده بود. همان گزارش، هزینه متوسط هر وظیفه در یکی از مقایسههای عاملمحور را حدود ۰٫۲۲ دلار اعلام میکند. این ارقام به مجموعه آزمونها و روش محاسبه مورد استفاده وابستهاند. جدول مقایسهای از اطلاعات منتشرشده شاخص نتیجه گزارششده Intelligence Index ۴۲ امتیاز امتیاز نسخه قبلی M3 در همان شاخص ۲۹ امتیاز هزینه متوسط یک وظیفه در مقایسه گزارششده حدود ۰٫۲۲ دلار قیمت هر یک میلیون توکن ورودی ۰٫۱۵ دلار قیمت هر یک میلیون توکن خروجی ۰٫۶۰ دلار سرعت استنتاج آنلاین نزدیک به ۳ برابر، طبق ادعای MiniMax این جدول ترکیبی از دادههای گزارششده و ادعاهای شرکت است؛ بنابراین نباید همه ردیفها را نتیجه آزمون مستقل یکسان در نظر گرفت. آیا مدل همیشه دقیق جواب میدهد؟ خیر. افزایش سرعت یا کاهش هزینه لزوماً به معنای کاهش خطا نیست. گزارش The Decoder با استناد به ارزیابی Artificial Analysis به نرخ بالای توهم در یکی از آزمونهای مربوط به پاسخگویی واقعیتمحور اشاره میکند. در این آزمون، مدل ممکن است به پرسشهایی پاسخ دهد که در آنها اطمینان کافی ندارد، بهجای آنکه عدم اطمینان خود را اعلام کند. این نکته برای کاربردهای حساس اهمیت زیادی دارد. در حوزههایی مانند امور مالی، امنیت سایبری، سلامت و توسعه نرمافزار، خروجی مدل باید با آزمون، نظارت و کنترلهای مناسب بررسی شود. انتخاب مدل صرفاً براساس قیمت یا سرعت میتواند ریسک خطا را نادیده بگیرد. مقایسه MiniMax M3.1 Flash با مدلهای رقیب رقابت در بازار مدلهای کمهزینه و سریع هوش مصنوعی شدیدتر شده است. مدلهایی مانند DeepSeek Flash و دیگر مدلهای سبکتر تلاش میکنند تعادل مناسبی میان توانایی استدلال، سرعت و هزینه ایجاد کنند. معیار اهمیت برای کاربران وضعیت M3.1 Flash هزینه اجرا کاهش هزینه پروژههای پرتکرار نقطه تمرکز اصلی معرفی سرعت پاسخ کاهش تأخیر در گردشکارها MiniMax از افزایش نزدیک به سهبرابری خبر میدهد کدنویسی تولید و اصلاح کد یکی از کاربردهای هدف عاملهای هوش مصنوعی انجام وظایف چندمرحلهای تمرکز اصلی مدل دقت و قابلیت اتکا کاهش خطا در کاربرد واقعی نیازمند ارزیابی متناسب با نوع وظیفه مقایسه منصفانه باید با نسخههای مشخص مدلها، تنظیمات یکسان و مجموعه آزمون مشترک انجام شود. حتی اگر یک مدل در یک بنچمارک برتری داشته باشد، ممکن است در کدنویسی، استدلال یا پاسخگویی دقیق نتیجه متفاوتی کسب کند. چگونه میتوان از MiniMax M3.1 Flash استفاده کرد؟ طبق مستندات و اطلاعیه رسمی شرکت، مدل از طریق API، طرح اشتراکی M Plan و ابزار توسعه MiniMax Code در دسترس قرار گرفته است. این گزینهها بیشتر برای توسعهدهندگان، تیمهای نرمافزاری و کسبوکارهایی مناسباند که میخواهند مدل را در ابزار یا فرایند کاری خود به کار بگیرند. پیش از استفاده در محصول نهایی، بهتر است هزینه واقعی اجرای چند وظیفه نمونه، میزان خطا، تأخیر پاسخ و کیفیت خروجی بررسی شود. جمعبندی معرفی MiniMax M3.1 Flash نشان میدهد رقابت در صنعت هوش مصنوعی بهسمت ساخت مدلهایی حرکت میکند که علاوه بر توانایی فنی، از نظر هزینه و سرعت نیز برای استفاده مداوم در دسترستر باشند. تمرکز بر کدنویسی، اجرای وظایف چندمرحلهای و کار با ابزارها میتواند این مدل را برای توسعهدهندگان و کسبوکارها جذاب کند. بااینحال، ادعاهای MiniMax درباره سرعت و کاهش هزینه باید در کنار نتایج آزمونهای مستقل بررسی شوند. برای انتخاب این مدل، مهمترین معیار فقط ارزانبودن نیست؛ بلکه نسبت کیفیت خروجی به هزینه، میزان خطا و عملکرد در وظیفه واقعی شماست. مطالب بیشتر OpenAI Dots چیست؟ دستیار هوش مصنوعی جدیدی که خودش برای شما کار میکند هوش مصنوعی مولد، مدل زبانی و چتبات چه تفاوتی دارند؟ قابلیت جدید ChatGPT؛ چطور چتهای حساس را با رمز عبور قفل کنیم؟ سؤالات متداول (FAQ) MiniMax M3.1 Flash چیست؟ یک مدل هوش مصنوعی از شرکت چینی MiniMax است که برای عاملهای هوش مصنوعی، کدنویسی، استفاده از ابزارها و اجرای وظایف چندمرحلهای بهینه شده است. آیا MiniMax M3.1 Flash رایگان است؟ استفاده از API براساس تعرفه اعلامشده هزینه دارد. شرایط دسترسی از طریق طرح M Plan یا ابزار MiniMax Code ممکن است متفاوت باشد؛ بنابراین باید جزئیات طرح موردنظر را در وبسایت رسمی بررسی کرد. هزینه API این مدل چقدر است؟ طبق اعلام شرکت، هر یک میلیون توکن ورودی ۰٫۱۵ دلار و هر یک میلیون توکن خروجی ۰٫۶۰ دلار هزینه دارد. ورودی ذخیرهشده نیز با نرخ ۰٫۰۱۵ دلار برای هر یک میلیون توکن محاسبه میشود. آیا M3.1 Flash از مدلهای رقیب بهتر است؟ نمیتوان آن را در همه کاربردها بهترین مدل دانست. نتایج به نوع وظیفه، تنظیمات اجرا و معیار ارزیابی بستگی دارند؛ بنابراین مقایسه مستقیم با مدلهای رقیب ضروری است. آیا میتوان از این مدل برای برنامهنویسی استفاده کرد؟ بله؛ برنامهنویسی و مهندسی نرمافزار از کاربردهای هدف آن هستند. بااینحال، کد تولیدشده باید از نظر صحت، امنیت و سازگاری آزمایش شود. موضوع AI Agents API هوش مصنوعی MiniMax MiniMax M3.1 Flash برنامه نویسی با هوش مصنوعی عامل هوش مصنوعی مدل زبانی مدلهای هوش مصنوعی هوش مصنوعی هوش مصنوعی چین منبع معرفی رسمی MiniMax M3.1 Flash در وبسایت MiniMax اشتراک در اشتراکگذاری در ایکس اشتراکگذاری در واتساپ اشتراکگذاری در واتساپ اشتراکگذاری در تلگرام
MiniMax M3.1 Flash معرفی شد؛ مدل چینی که روی سرعت و هزینه کمتر تمرکز دارد
آی تی جو > دنیای فناوری > هوش مصنوعی > MiniMax M3.1 Flash معرفی شد؛ مدل چینی که روی سرعت و هزینه کمتر تمرکز دارد MiniMax M3.1 Flash معرفی شد؛ مدل چینی که روی سرعت و هزینه کمتر تمرکز دارد MiniMax M3.1 Flash مدل هوش مصنوعی جدید شرکت چینی MiniMax است که برای کدنویسی و اجرای وظایف عاملمحور طراحی شده اس