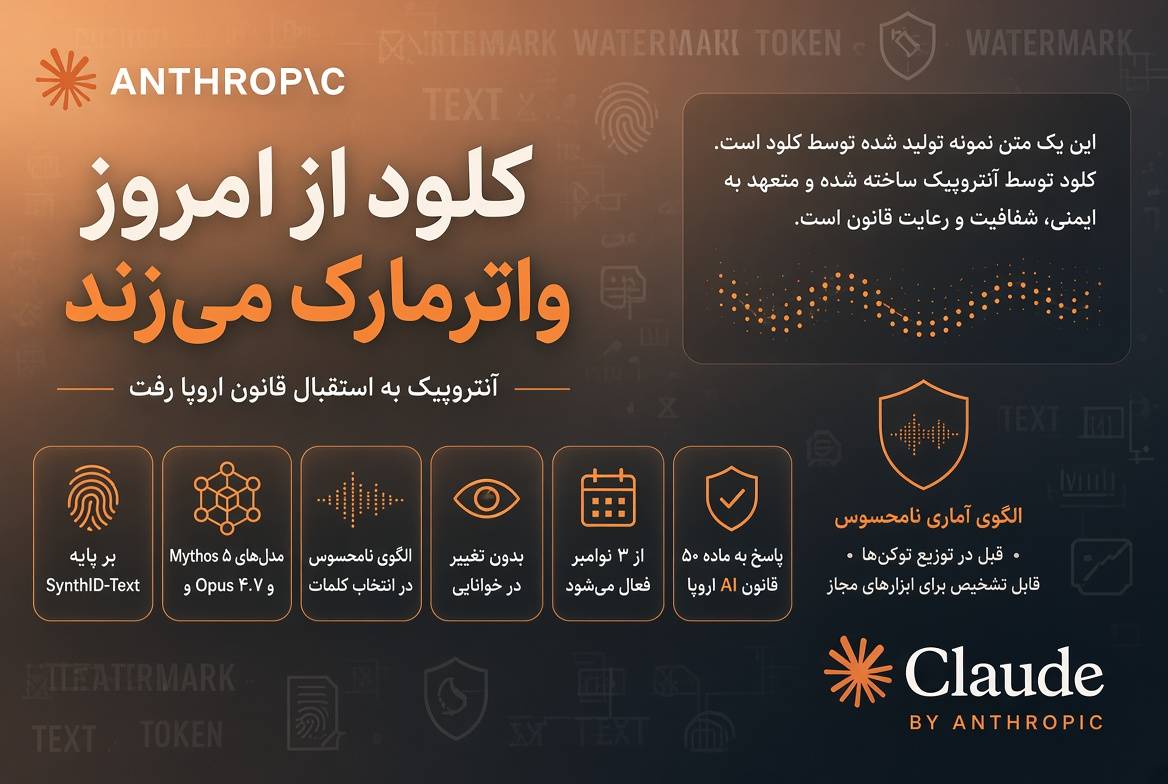
به گزارش آی سی تی نیوز؛ آنتروپیک در ۳۰ اکتبر ۲۰۲۶ (۸ آبان ۱۴۰۵) از طریق ایمیل به مشتریان خود اعلام کرد که فناوری واترمارک پنهان متون را از ۳ نوامبر (۱۲ آبان) به مدلهای قدیمیتر Claude اضافه میکند. این اقدام در پاسخ به قوانین شفافیت اتحادیه اروپا (Article 50 AI Act) انجام میشود .
مدلهای تحت تأثیر
واترمارک روی مدلهای Claude Mythos 5، Opus 4.7، Opus 4.6 و Sonnet 4.6 فعال خواهد شد. این فناوری بدون تغییر در خوانایی متون یا ثبت هویت افراد، متون ماشینی را نشانهگذاری میکند. هدف اعلامشده، مقابله با تقلب در تولید محتوا، مقالات علمی و متون حقوقی است .
نحوه کارکرد فنی
واترمارک آنتروپیک بر پایه SynthID-Text گوگل دیپمایند ساخته شده و از یک «الگوی نامحسوس در انتخاب کلمات» استفاده میکند. مدل هنگام تولید متن، از یک کلید رمزنگاری برای انتخاب میان کلمات همارز استفاده میکند و الگویی آماری در متن ایجاد میشود که فقط با داشتن کلید قابل تشخیص است. این یعنی واترمارک هیچ کاراکتر اضافه یا متادیتایی به متن اضافه نمیکند .
محدودیتهای تشخیص
تشخیص واترمارک فقط احتمال involvement Claude را نشان میدهد، نه اثبات قطعی. در متون کوتاه، واقعیات دقیق و کد سیگنال ضعیف است. بازنویسی سنگین یا پردازش با مدل دیگر میتواند واترمارک را حذف کند .
گسترش به ویرایشهای جزئی
نکته حساس این است که واترمارک روی هر متنی که Claude پردازش کند اعمال میشود، حتی اگر فقط برای ویرایش گرامری، ترجمه یا خلاصهسازی استفاده شده باشد. این یعنی متنی که کاربر انسانی نوشته اما Claude آن را ویرایش کرده، ممکن است واترمارک دریافت کند، در حالی که قانون اروپا برای «ویرایش کمکی» استثنا قائل شده است .
عدم شفافیت درباره ابزار تشخیص
آنتروپیک اعلام کرده ابزار تشخیص واترمارک در دسترس تنظیمکنندگان، رسانه، محققان و مؤسسات آموزشی قرار خواهد گرفت، اما جزئیات دقیق اینکه چه کسی و چگونه به آن دسترسی دارد، هنوز مشخص نیست .
نگرانی کاربران
در Reddit، کاربران به این نکته اشاره کردهاند که غیربومیزبانان و افراد دارای نارساخوانی که از Claude برای ویرایش یا ترجمه استفاده میکنند، ممکن است ناخواسته واترمارک دریافت کنند، در حالی که دانشجویانی که کل مقاله را با AI نوشتهاند، همین وضعیت را دارند. این نگرانی درباره «برچسبگذاری ناعادلانه» در گزارشهای اولیه کمتر دیده شد .
تحلیل ICTNews
واترمارک متنی آنتروپیک را باید در چارچوب یک تحول گستردهتر دید: قانونگذاری بر محتوای AI در حال تبدیل شدن به واقعیت عملیاتی است. اتحادیه اروپا با Article 50 AI Act، شرکتها را ملزم کرده که محتوای تولیدشده با AI را برچسبگذاری کنند. آنتروپیک با پذیرش SynthID-Text، نهتنها به این الزام پاسخ داده، بلکه استانداردی را پذیرفته که گوگل توسعه داده است، نشانهای از همگرایی صنعتی حول یک استاندارد مشترک.
اما دو نکته را نباید از نظر دور داشت. نخست، واترمارک راهحل کاملی نیست. تشخیص آن فقط احتمال را نشان میدهد، در متون کوتاه و کد ضعیف است و با بازنویسی حذف میشود. این یعنی دانشجویی که متن Claude را کمی بازنویسی کند، ممکن است از تشخیص فرار کند، در حالی که کاربری که فقط برای ویرایش گرامری از Claude استفاده کرده، واترمارک دریافت میکند. این عدم تقارن میتواند به بیاعتمادی به سیستم منجر شود.
دوم، عدم شفافیت درباره ابزار تشخیص. تا زمانی که مشخص نشود چه کسی و با چه معیاری میتواند واترمارک را تشخیص دهد، خطر استفاده ابزاری از این فناوری وجود دارد؛ مثلاً استادانی که بدون تخصص فنی، متون دانشجویان را بر اساس تشخیص واترمارک قضاوت کنند. آنتروپیک باید هرچه سریعتر جزئیات دسترسی و محدودیتهای ابزار تشخیص را شفاف کند.
در مجموع، این اقدام آنتروپیک گامی مثبت در جهت شفافیت محتوای AI است، اما بدون شفافیت در تشخیص و توجه به موارد استثنا (ویرایش کمکی، غیربومیزبانان)، میتواند به برچسبگذاری ناعادلانه منجر شود.